EmDash で日本語のサイトを作るときに手を入れる 3か所
Cloudflare が出した Astro 製の CMS である EmDash で、WordPress から移した日本語のサイトを動かしているんですが、検索、URL、見出しのように日本語の文字がそのまま入る所で、英語のサイトでは要らない手直しが出てきました。どこに手を入れればよいかを確かめ、検索は日本語の技術記事が 173本ある当サイトで測りました。
EmDash は日本語の記事をそのまま保存して表示できますが、日本語のサイトでは公開前に自分で決めて手を入れる所が 3か所あります。必ず決めるのはサイト内検索で、標準の検索は既定のままだと日本語のキーワードを取りこぼし、キーワードによっては本来対象になる記事の半分以下しか返しません。残りの 2か所は URL の形や見た目をどうしたいかで決める所で、管理画面は日本語のタイトルから日本語のスラッグを作り、見出しは語の途中で改行されます。
サイト内検索は、探される語が 3文字以上かどうかで直し方を選ぶ
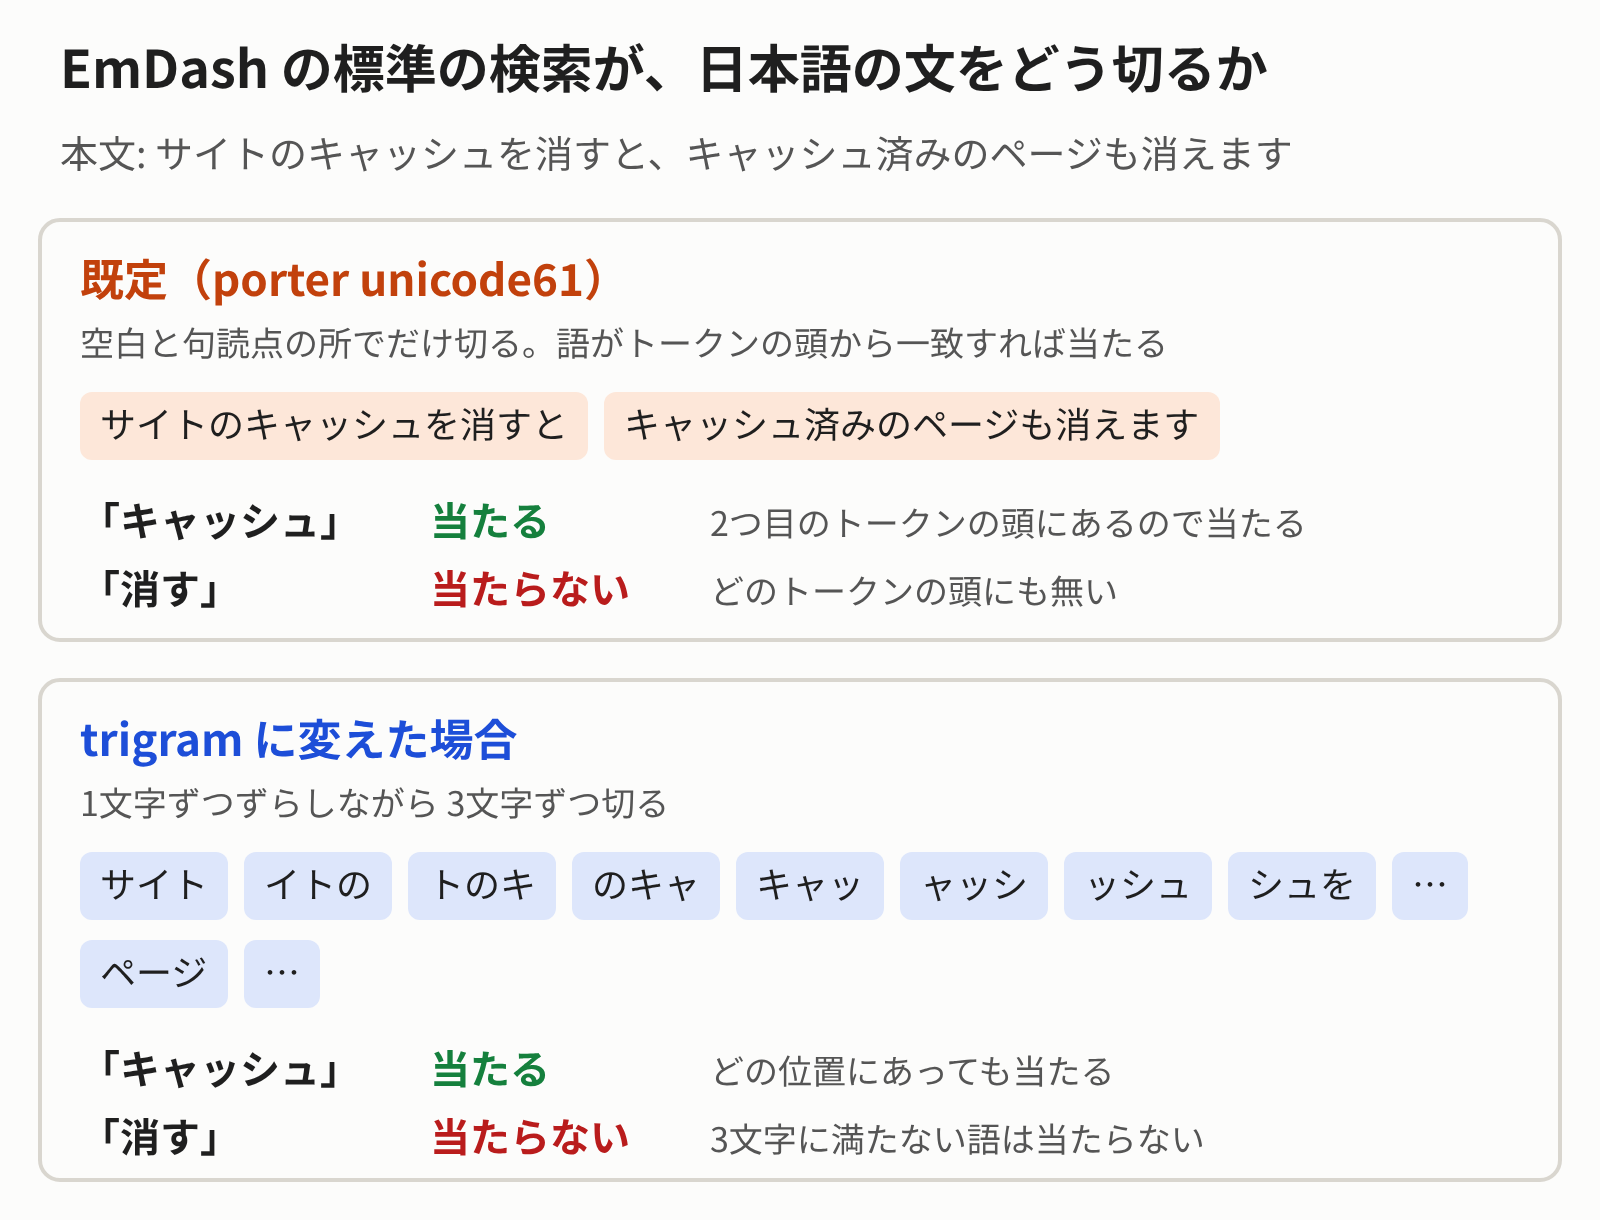
EmDash の標準のサイト内検索は、記事のタイトルと本文を D1(Cloudflare の SQLite のデータベース)の全文検索 FTS5 に入れて検索します。文の切り方(tokenizer)の既定は英語向けの porter unicode61 という SQLite の FTS5 の tokenizer で、空白と句読点の所でしか文を切らず、打った語はトークンの頭から一致するか(前方一致)で探します。
そのため、日本語の文の途中にあるキーワードは当たりません。「サイトのキャッシュを消すと、キャッシュ済みのページも消えます」は「サイトのキャッシュを消すと」と「キャッシュ済みのページも消えます」の 2つのトークンになり、「キャッシュ」は 2つ目のトークンの頭にあるので当たりますが、「消す」はどのトークンの頭にも無いので当たりません。
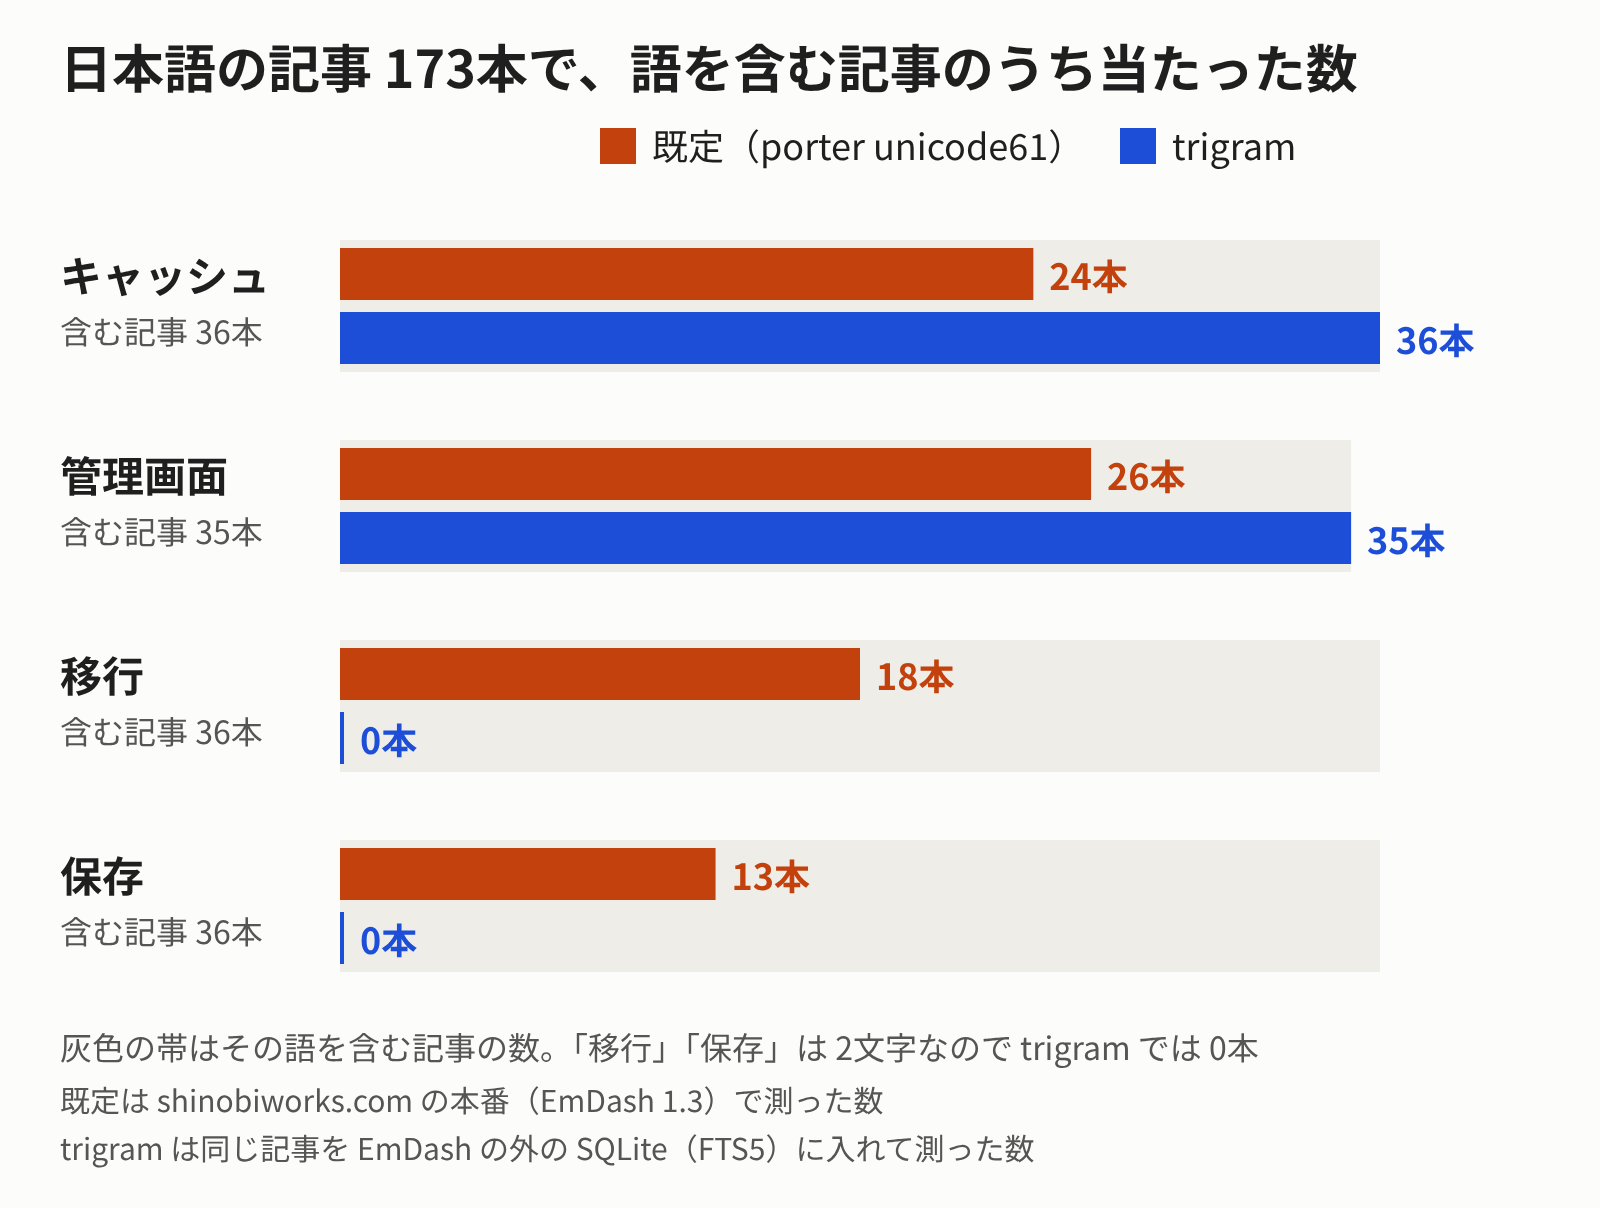
EmDash 1.3 で動く当サイトの本番で公開中の日本語の記事 173本をキーワードごとに検索すると、標準の検索が返したのは「キャッシュ」が入った 36本のうち 24本、「保存」が入った 36本のうち 13本でした。
tokenizer には trigram も選べます。trigram は、文を 1文字ずつずらしながら 3文字ずつ切ってインデックスを作る方式です。本番の設定は変えずに、私が同じ 173本を EmDash の外の SQLite の FTS5 に trigram で入れ、同じ前方一致で検索すると、「キャッシュ」は 36本中 36本、「管理画面」は 35本中 35本と全部当たりました。ただ、「移行」「保存」「公開」のような 2文字の語は 0本でした。
tokenizer は管理画面にもサイトの初期設定を書くファイル(seed.json)にも欄が無く、REST API でしか変えられません。検索を有効にするエンドポイント(search enable)に、コレクションごとに tokenize: "trigram" を付けて送ります。コレクションは記事などの内容の種類ごとの入れ物で、WordPress の投稿タイプに当たります。検索が有効なコレクションで変えると、そのコレクションのインデックスが作り直されます。
訪問者が 3文字以上の語で探すサイトなら、trigram にすれば足ります。「移行」「料金」「保存」のような 2文字の語でも探すサイトでは、trigram だと 2文字の語が当たりません。EmDash の REST API の文書の Search tokenizers の節にも、trigram は日本語のような空白の無い言語向けで 3文字未満の語には何も返さないと書かれています。かといって既定の tokenizer に戻しても取りこぼす語が出ます。そのため 2文字の語でも探すサイトでは、標準の検索に別の検索を組み合わせる必要があります。
たとえば当サイトは、意味の近さでも探す Cloudflare の AI Search と、既定の tokenizer のままの標準の検索を組み合わせています。2文字以下の語は、まず標準の検索で探し、結果が無ければ AI Search を呼びます。3文字以上の語は最初から AI Search を呼びます。AI Search の作り方は Cloudflare AI Search で、質問の文でも当たるサイト内検索を付ける に書きました。
英語や番号の URL にしたいなら、日本語のスラッグを付け直す
EmDash の管理画面は、記事のタイトルからスラッグを作ります。日本語を含む文字と数字は残し、空白はハイフンにして英字は小文字にするので、「EmDash を本番で半年使った料金」は emdash-を本番で半年使った料金 に、「サイトをリニューアルしました」は サイトをリニューアルしました になります。URL には日本語がそのまま入り、コピーして貼ると URL エンコードされた長い URL になります。英語や番号の URL にしたいなら、管理画面が作ったスラッグのまま公開せず、公開前に付け直すか、作った直後に直す処理を足すことになります。
WordPress が書き出したファイル(WXR)から取り込むと、WordPress が作った日本語のスラッグは %e3%82%bf… のような小文字の URL エンコードの形のまま入ります。WXR から移して日本語のスラッグを英語に付け直し、旧 URL から 301 リダイレクトを張るなら、リダイレクトの表の旧 URL は大文字にそろえておく必要があります。ブラウザは %E3%82%BF… と大文字で送ってくるので、小文字のままでは一致せず、私が付け直したサイトでも日本語の旧 URL のリダイレクトだけが効きませんでした。表に入れるときに一度デコードしてエンコードし直すと、大文字にそろいます。詳しくは 日本語 URL の 301 リダイレクトだけが効かない原因 に書きました。
見出しの改行を整えたいなら、Workers で動く形で BudouX を読み込む
ブラウザは日本語の見出しを語の途中でも折り返し、これは EmDash に限らず起きます。Google の BudouX は文を意味の切れ目で分ける機械学習のライブラリです。見出しやタイトルの改行位置を整えたいなら、BudouX で切れ目に <wbr> を入れ、CSS の word-break: keep-all と組み合わせる方法があり、当サイトもこの方法を使っています。
EmDash で詰まるのは BudouX を読み込む所です。EmDash は Astro のサーバーレンダリングで Cloudflare Workers の上で動くので、BudouX をそのまま import すると ReferenceError: window is not defined で落ちます。パッケージの入口が、ブラウザでしか動かない HTML 処理の部品を一緒に読み込むためです。詳しい原因は BudouX を Cloudflare Workers で使うと window is not defined に書きました。budoux 0.6.4 では、budoux/module/parser.js の Parser と日本語のモデルを直接 import すると動きます。