Cloudflare AI Search で、質問の文でも当たるサイト内検索を付ける
Cloudflare の AI Search(旧 AutoRAG)は、ファイルを上げるか R2 のバケットやサイトをつなぐと、文書を切って索引を作り、Workers や REST API から文で検索できるようにするサービスです。キーワード検索とベクトル検索(意味の近さで探す検索)の結果を混ぜて返すので、検索窓に打った語が本文に無くても、中身が近い記事が見つかります。
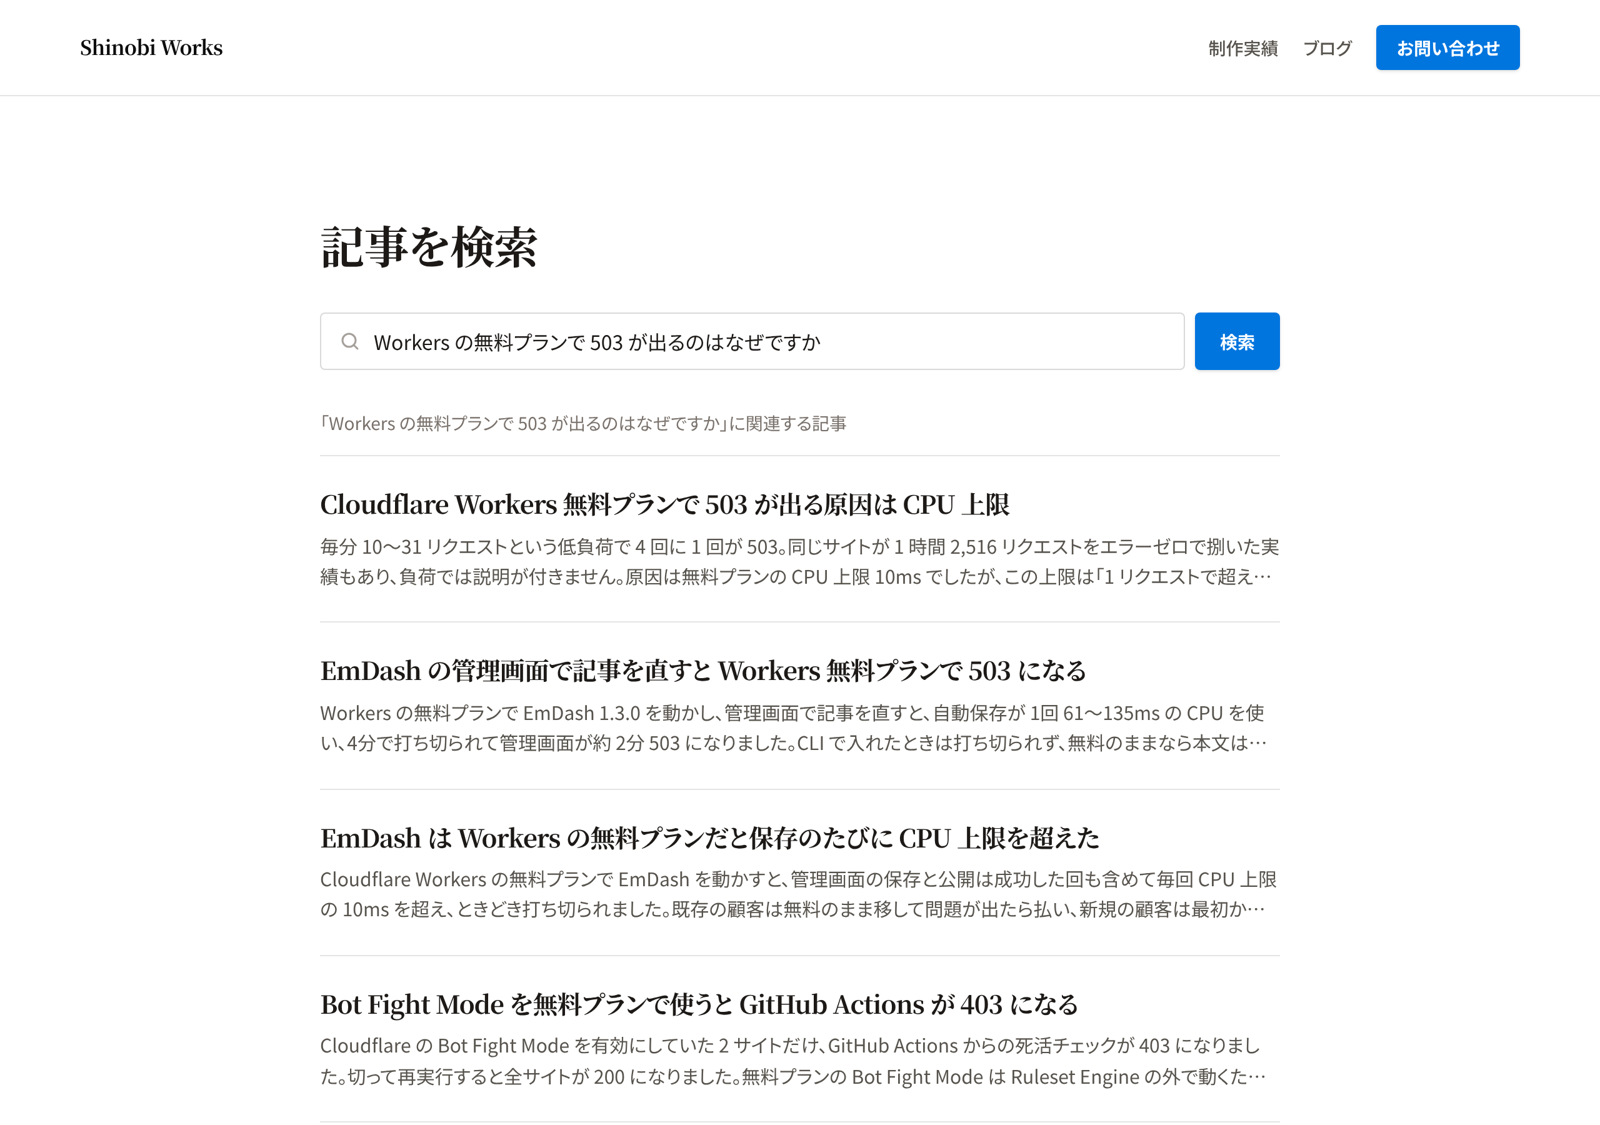
Astro 製の CMS「EmDash」のような CMS が標準で持つ全文検索は、文字が一致する記事しか返しません。日本語の技術記事 172本で質問の文を 10個引くと、EmDash 標準の全文検索(D1 の FTS5)は 10個とも 0件で、AI Search はすべてで狙った記事を 2位以内に返しました。次の画面は、AI Search で作ったサイト内検索に「Workers の無料プランで 503 が出るのはなぜですか」と打った結果です。この文をそのまま含む記事は無く、全文検索では何も返りません。
以下は、EmDash のサイトを Workers の無料プランで動かしたまま、この検索を付ける手順です。
1. サイトをつないで記事だけの索引を作る
AI Search のインスタンスを作り、データの元に「Website」を選んでサイトをつなぎます。記事以外のページまで索引に入ると、トップや一覧のページが検索結果に混ざるので、次の 3つで記事だけに絞ります。
- 読み込むページ: 記事だけのサイトマップ(
sitemap-posts.xml)を指定し、/posts/**だけを含め、タグとカテゴリの一覧は外す - 読み込む部分: content selector で
/posts/**のページはarticle要素だけを取り込む。ヘッダーや関連記事の文で当たらなくなる - 題と抜粋: custom metadata に
titleとdescriptionを定義する。ページの<meta name="description">などから取り込まれ、検索結果の一覧に題と抜粋を出すのに使える
検索の方式はハイブリッド(キーワード検索とベクトル検索)にします。キーワード検索の切り方を決める keyword_tokenizer は、日本語なら trigram を選べます。文を 1文字ずつずらしながら 3文字ずつ切る方式で、「キャッシュ済」なら「キャッ」「ャッシ」「ッシュ」「シュ済」と切るので、空白の無い日本語の文でもキーワード検索が当たります。既定の porter は空白で語を切るため、日本語の文はひとまとまりの 1語になり、キーワード検索はほぼ 0件です。
ただ、172本で比べると、記事を探す人が打ちそうなクエリ 30個のうち 28個は、既定の porter でも trigram でも正解の記事が上位 5件に入りました。日本語でもベクトル検索が拾うからです。trigram で増えたのは、1本の記事にしか出てこない語(「キャッシュ済」「パーマリンク」など)をそのまま打ったときで、20語中 12語が 17語になりました。代わりに索引を作る時間は約 6分から約 19分に延びます。型番や設定名のような語をそのまま打たれるサイトなら trigram、質問の文が多いなら既定のままで足ります。
記事 172本の取り込みは約 25分で終わり、その後は 6時間ごとにサイトマップを読み直して新しい記事を取り込みます。
2. Worker から検索を呼ぶ
検索結果のページ(/search)は、まずサーバーで EmDash 標準の全文検索の結果を出し、ページを開いたブラウザが JavaScript で検索の口(/search/ai)に問い合わせて、AI Search の結果に差し替える作りにしました。AI Search が返らないときや止めたときは、その全文検索の結果を出します。
wrangler.jsonc に AI Search の binding を足します。
"ai_search": [
	{ "binding": "AI_SEARCH", "instance_name": "shinobiworks-posts" }
]
AI Search の binding は手元では動かず、astro dev は起動時に Cloudflare へつなぎにいくので、API の鍵が無いと起動しません。手元では検索を諦めてよいなら、@astrojs/cloudflare の設定で remoteBindings: false にします。
検索は search() を呼ぶだけです。返るのは記事ではなくチャンク(記事を切った断片)なので、1本の記事から何個も返ります。上限の 50個まで取って記事ごとにまとめ、最初に出てきた順に並べると、10本の一覧になります。題と抜粋は custom metadata から取れるので、本文は受け取らなくて済みます。
const result = await env.AI_SEARCH.search({
	query,
	ai_search_options: { retrieval: { max_num_results: 50, metadata_only: true } },
});
// result.chunks[i].item.key は記事の URL、item.metadata に title と description が入る
3. 意味だけで当たった記事は後ろに回す
ベクトル検索は、語が本文に出てこない記事にも近さの点を付けます。「外注」「相槌」のような 2文字の語は trigram でも 3文字に満たず当たらないので、ベクトル検索だけの結果になり、この語が出てこない記事が 0.4 前後の近さで並びました。
各チャンクの scoring_details を見ると、キーワード検索で当たったか(keyword_rank がある)と、ベクトル検索の近さ(vector_score)が分かります。キーワード検索でも当たったか、近さが 0.5 以上のチャンクを持つ記事を「強い当たり」とし、強い当たり、全文検索の結果、何も無ければ弱い当たり、の順に出すと、関係の薄い記事が先頭に来なくなります。2文字以下の語で全文検索が当たっているなら、AI Search はそもそも呼ばずに全文検索の結果を出します。
4. 無料で使える回数に収める
AI Search は 2026年11月から課金が始まり、毎月無料で使えるのは、ベクトル検索とハイブリッド検索を合わせて 1,000回です。それを超えた分はハイブリッド検索なら 1,000回あたり $0.75 です(料金のページ)。サイト内検索の口を公開すると、ボットや連打でこの回数が減るので、呼ぶ前に次の順で止めます。止めたときは全文検索の結果をそのまま出すので、検索窓が動かなくなることはありません。
- 検索結果のページを開いたブラウザが JavaScript で送った POST だけを受ける(
Sec-Fetch-Site: same-originとOriginを確かめる。URL を開いただけでは呼ばない) - 同じ語の結果は Cache API で 1日使い回す
- 同じ IP から 1分に 10回を超えたら呼ばない(Workers の Rate Limiting の binding)
- 月の呼び出しを D1 で数え、900回で月末まで止める
AI Search が返るまで Worker は待つだけなので、検索の口の CPU 時間はふだん 3〜6ms で、無料プランの上限 10ms に収まりました。応答は 2回目以降なら 0.25〜2.4秒ですが、しばらく呼ばれなかった後の最初の 1回は 5.6秒かかったので、ブラウザ側は 10秒まで待ってから全文検索の結果に戻すようにしています。