robots.txt の AI 学習の共通トークンは今の行と並べて書ける
OpenAI・Google・Microsoft が、AI の学習の可否を robots.txt の共通の書き方で示せるようにすると発表しました。学習について何も書いていない当サイトの robots.txt に足しても、今の指定が崩れないか確かめてみました。
共通の書き方は、標準になる前の個人の提案であるドラフトで定められていて、User-agent に __usage_ai-training というトークンを書く形です。このトークンはクローラーの名前ではなく、学習の可否を示す名前です。
- 当サイトの robots.txt(
User-agent: *のグループだけ)と、例として作った GPTBot・Google-Extended を断る robots.txt の末尾に、トークンのグループを足す - 足す前と後で、クローラーの名前 8つ × パス 7つの許可・拒否を、robots.txt を読んで答えを返すライブラリ(パーサー)4つに問い合わせて比べる
- パーサーに
__usage_ai-trainingを名前として渡して判定させた答えを、ドラフトの読み方と比べる
4つのパーサーで、User-agent ごとの判定が変わったのは 448件中 0件でした。ドラフトでは * や GPTBot の Disallow はトークンのグループの代わりになりません。Google と OpenAI は各社のクローラー用のグループを並べずに済むとうたいますが、まだどの会社も対応していません。Google は 2027年の対応を目指し、Microsoft は 2027年2月、OpenAI は数か月内に対応するとしています。学習を断るなら、今は GPTBot などの既存のグループと並べて、トークンのグループを足します。
User-agent: *
Disallow: /admin/

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: __usage_ai-training
Disallow: /

Sitemap: https://example.com/sitemap.xml
4つのパーサーで User-agent ごとの判定は変わらない
トークンのグループは、新しい指示も文法も足さず、User-agent の行にトークンを書くだけの形です。ドラフトに載っている次の例では、/press-kit/ の下だけ学習を許し、それ以外は断ります。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
ドラフトによると、既存のパーサーはこのグループを知らない User-agent のグループとして無視するので、今の判定は変わりません。ドラフトは、robots.txt の仕様の RFC 9309 どおりのパーサーだけでなく、実際に使われているパーサーでもそうなることを目標にしています。
試したパーサーは、Python の標準ライブラリの urllib.robotparser、Scrapy が使う Protego、Google が公開している robots.txt パーサーを Python に移した robotspy、Node.js の robots-parser です。
Googlebot・Bingbot・GPTBot・Google-Extended などのクローラーの名前と、トップ・記事・管理画面・画像・検索ページなどのパスを組み合わせ、1つの robots.txt につき 224件を問い合わせました。2つの robots.txt のどちらでも、トークンのグループを足した後に答えが変わった問い合わせはありませんでした。
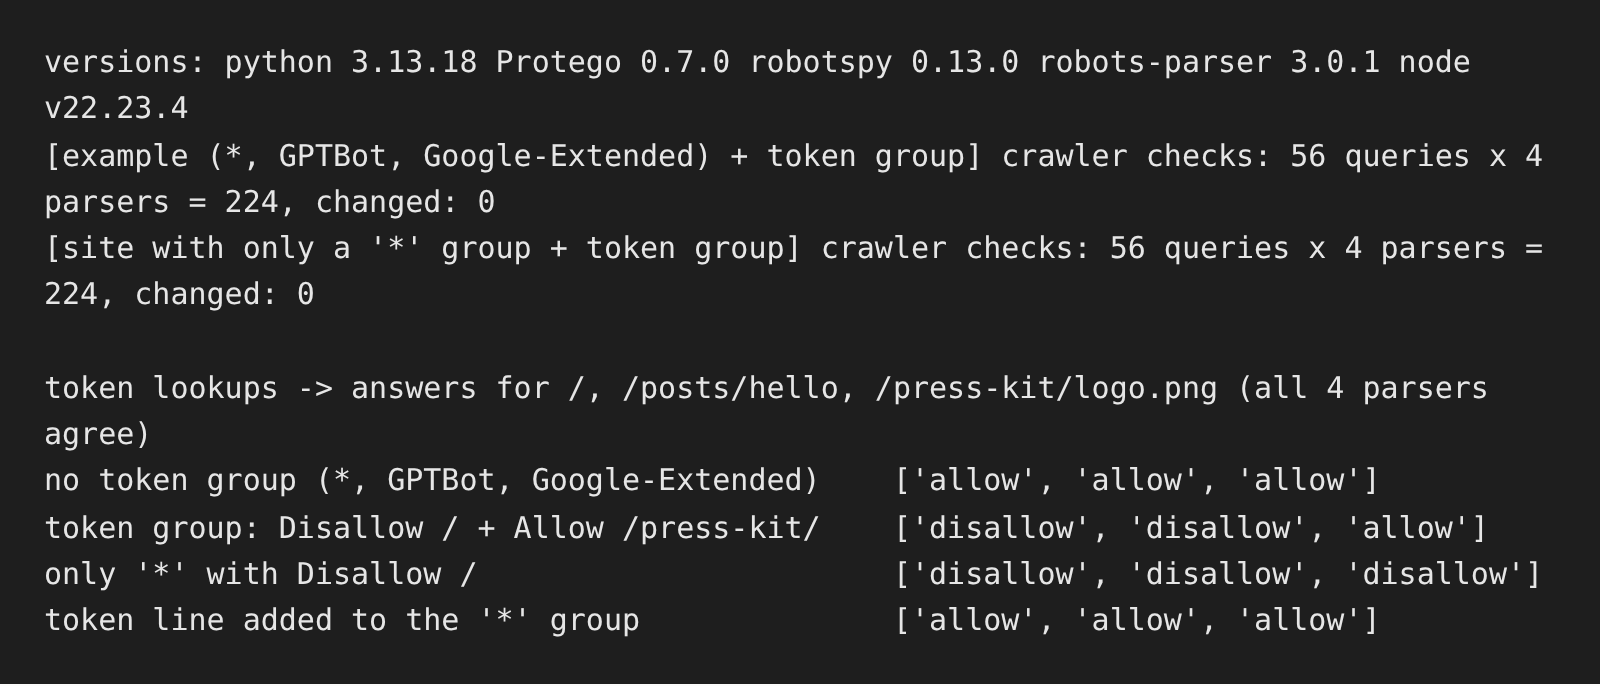
ドラフトが学習の可否として読むのはトークンのグループだけ
ドラフトでは * のグループはトークンに使われず、トークンのグループが無いファイルは学習について何も書いていないのと同じです。GPTBot などの社ごとの名前のグループも、共通の仕組みでは学習の可否としては読みません。それでも GPTBot の行は OpenAI に、Google-Extended の行は Google に今も効きます。
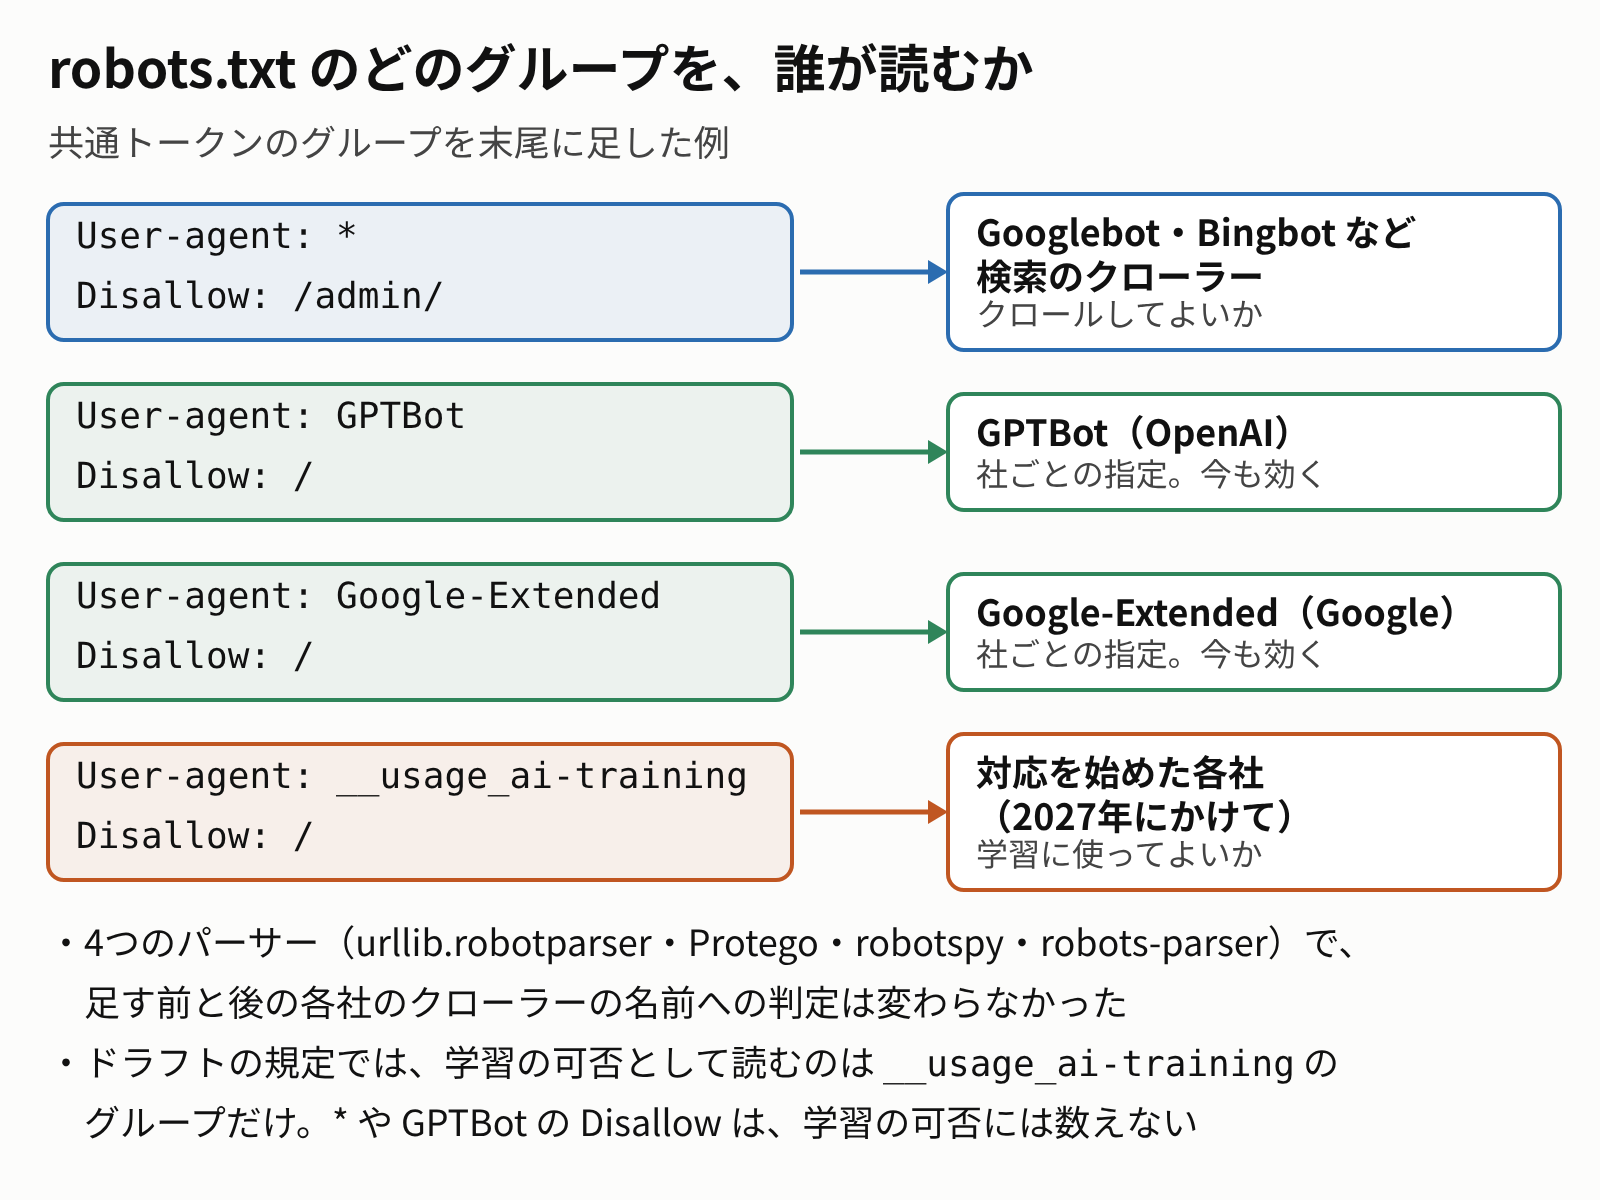
パーサーの答えはドラフトの読み方と食い違います。トークンで判定させると、トークンのグループが無いファイルでは 4つとも * のグループの規則で答えました。User-agent: * に Disallow: / だけのファイルでは / も /posts/hello も「拒否」で、GPTBot と Google-Extended を断るファイルでは * のグループが /admin/ しか拒否していないので「許可」です。サイトの側では、トークンのグループを書かずに * の Disallow で済ませると、ドラフトに沿って読む会社には何も指定していないことになるので、トークンのグループをちゃんと書く必要があります。
トークンの行を今の User-agent: * のグループに 1行足す書き方もでき、ドラフトもトークンと他の名前を 1つのグループに混ぜてよいと書いています。ただ、次の書き方は /admin/ 以外の学習を許したことになり、4つのパーサーもトークンで判定させると / と /posts/hello を「許可」と返しました。
User-agent: *
User-agent: __usage_ai-training
Disallow: /admin/
各社の対応が始まっても社ごとのグループは同じ範囲で残す
トークンに対応する時期は会社ごとに違い、Google は 2027年の対応を目指し、Microsoft は Bing のクロールで 2027年2月1日から対応し、OpenAI は今後数か月で対応を始めて詳細は後で出すとしています。
Google と OpenAI は対応の後も Google-Extended や GPTBot などの社ごとの指定が効き続けると書いていて、社ごとの指定を消してよいとはどちらも書いていません。
ドラフトは、各社が自分の名前のグループをトークンより具体的なものとして扱ってよいとしています。GPTBot のグループで許可してトークンのグループで拒否するように逆のことを書くと、その会社には GPTBot のグループの方が優先されることがあるので、社ごとのグループにもトークンのグループと同じ範囲の Disallow と Allow を書いておく必要があります。
Google-Extended を書いていなくても、トークンで学習を断れば、Google はそのサイトを Google-Extended を拒否したものと読む予定です。ただ、Google によると、Google-Extended を明示的に許可したサイトは Gemini アプリの回答に使われ、引用からの流入を得られます。トークンだけで断ったサイトは、この引用と流入も無くなるはずです。学習は断っても Gemini での引用は受けたいなら、User-agent: Google-Extended のグループで許可を明示する必要があります。
何をしたいかで、書き方は次のとおりです。
- 全部の学習を断る: 社ごとのグループを残し、末尾のトークンのグループに
Disallow: /を書く。Gemini アプリの回答で引用されたいなら、Google-Extended のグループは許可を明示する。学習を断ってもクロールは止まらず、ページを取りに来るかは*や各社の名前のグループのとおり - 一部だけ学習を許す: ドラフトの例のようにトークンのグループに
Disallow: /とAllow: /press-kit/を並べ、社ごとのグループも同じ範囲に合わせる - 学習に使われてよい: トークンのグループに
Allow: /を書くか、*のグループにトークンの行を足す。GPTBot や Google-Extended のDisallowを残すとその会社にはそちらが優先されることがあるので、社ごとのグループも同じ範囲に合わせる - 何も書かない: 学習について何も指定していない扱いになり、
*のDisallowはその代わりにならない
確かめたのはパーサーの判定まで
448件の結果はパーサーで確かめた物で、各社のクローラーが実際にトークンに従うかは、どの会社もまだ始めていないので試していません。Gemini の引用の話も、Google のブログの記述から読んだ物です。Googlebot そのものや Google の C++ のパーサーも試しておらず、Google のパーサーとして確かめたのは Python に移した robotspy です。
ドラフトが対象にするのは生成 AI モデルの学習で、分類・ランキング・採点だけに使うモデルは含みません。個別の契約がある場合は、その契約がトークンの指定より優先されることがあります。